生产排程系统怎么落地:先把约束写清,再谈自动排产
生产排程系统要落地,第一步不是挑算法,而是把车间的真实约束写成可计算的规则:设备能做什么、换型要多久、物料什么时候齐套、哪些订单不能动。约束写得清,排出来的计划才有人执行;约束写不清,再好的求解器也只能输出一份没人认的表格。常见做法是先用有限产能排程替代手工排产,把计划与现场实际逐周对照,再逐步引入优化目标。
一、排程排不下去,常见原因不在算法
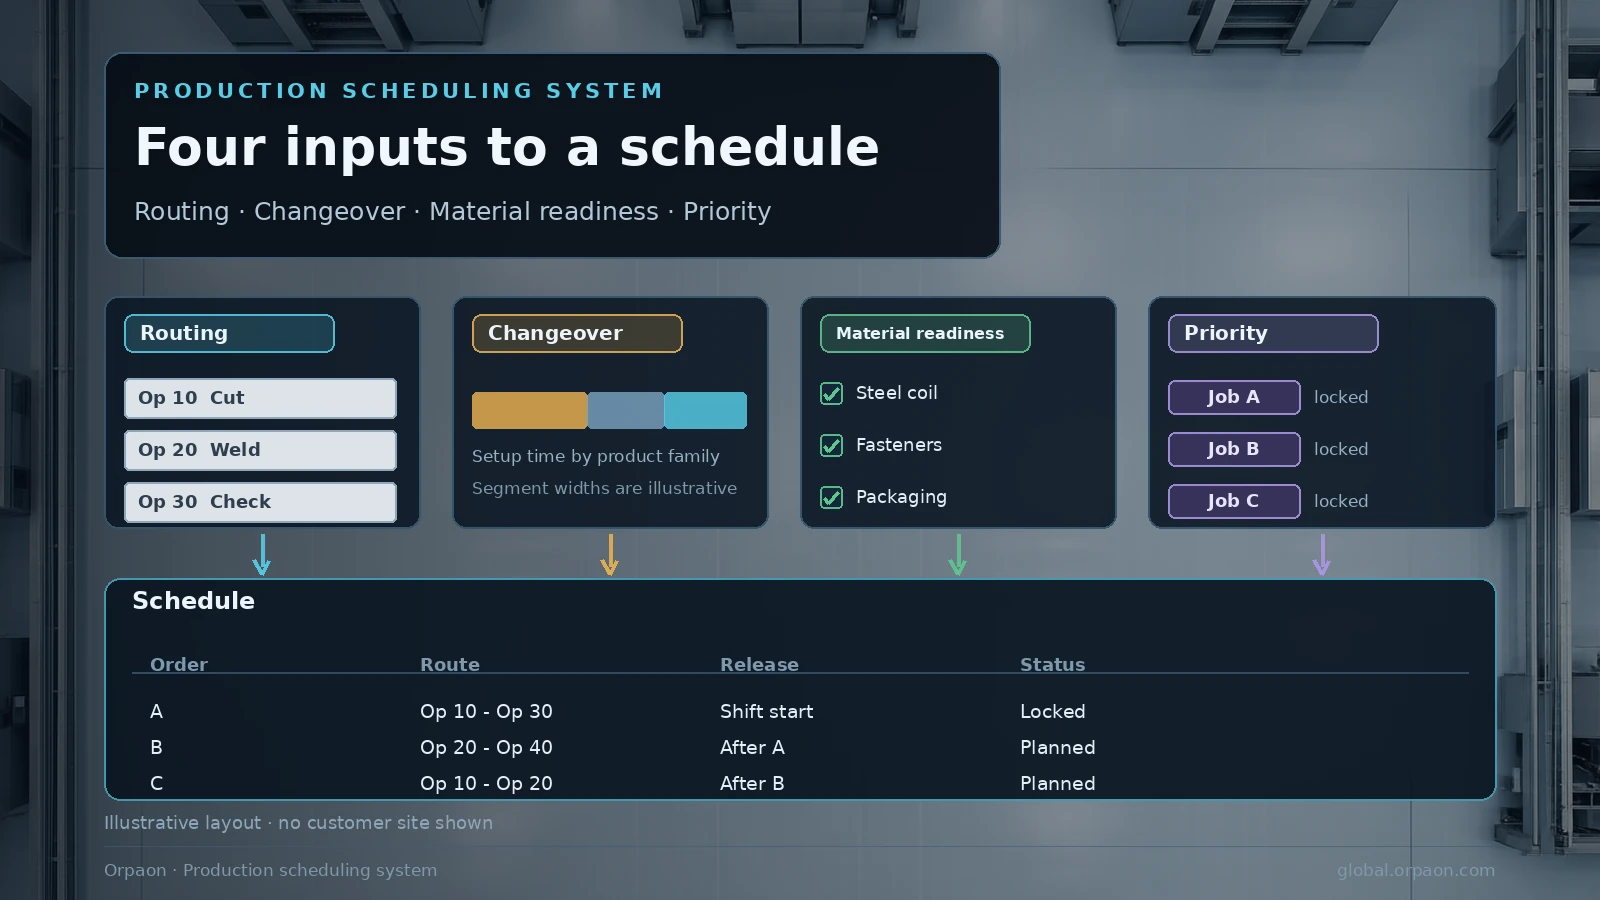
排程失败的表现很一致:系统排出计划,班组长看一眼放到一边,继续按经验安排。回头看,问题多半不在求解器,而在于输入本身不可信。工艺路线缺工序、换型时间用统一平均值、物料齐套状态查不到,这三件事同时存在时,排程结果只能算一次练习。
- 工艺路线不完整:工序、设备组与标准工时缺失或与实际不符,排程只能按假设数据计算
- 换型时间按固定值录入:同一设备切换不同产品的实际耗时差别很大,计划因此频繁重排
- 物料齐套状态不可见:排到某天却发现关键物料未到,计划当场作废
- 优先级没有统一口径:交期、客户等级、瓶颈工序谁先谁后,没有写成规则,结果自然不被承认
二、先把三类约束写清楚
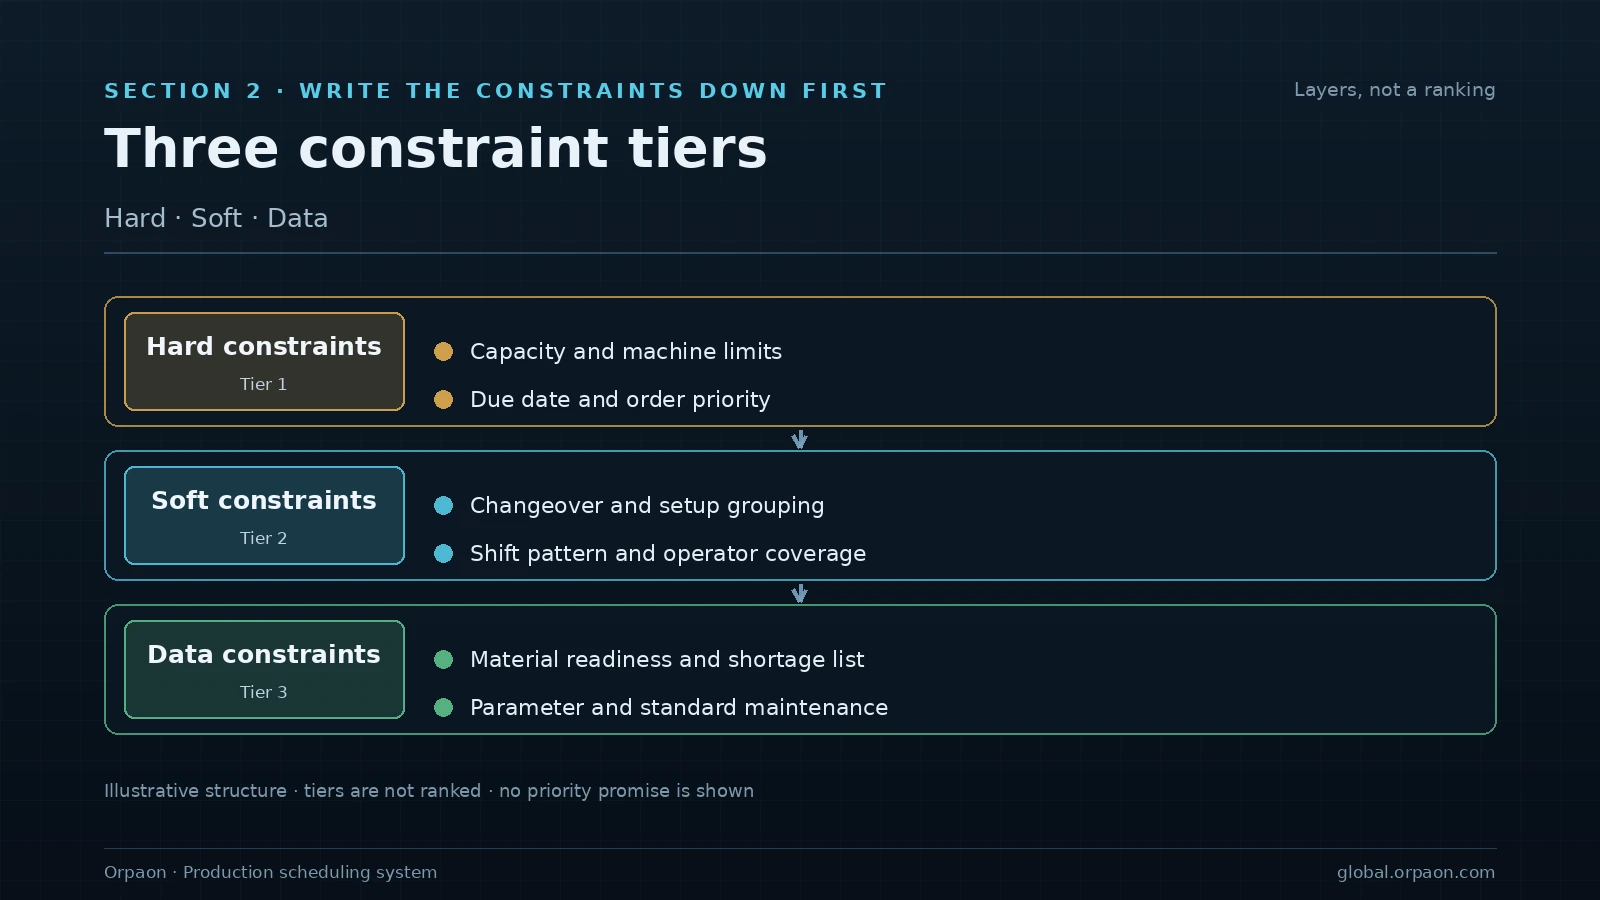
排程的输入可以分成三类:不可违反的硬约束、可以权衡的软约束,以及决定计划是否可信的数据约束。三类分开写的好处是,当计划被质疑时,能迅速判断是规则问题、取舍问题,还是数据问题。
| 约束类型 | 写清楚的内容 | 常见缺失 |
|---|---|---|
| 硬约束,不可违反 | 设备能力与工艺路线、模具与工装数量、班次与人力上限 | 设备与工序的对应关系只写在老师傅记忆里 |
| 软约束,可以权衡 | 换型时间、交期宽裕度、客户优先级 | 换型时间统一取平均值,未按产品组合区分 |
| 数据约束,决定可信度 | 标准工时、物料齐套时点、在制品数量 | 工时按理论值录入,未按实际节拍校正 |
三、排程要接回现场数据
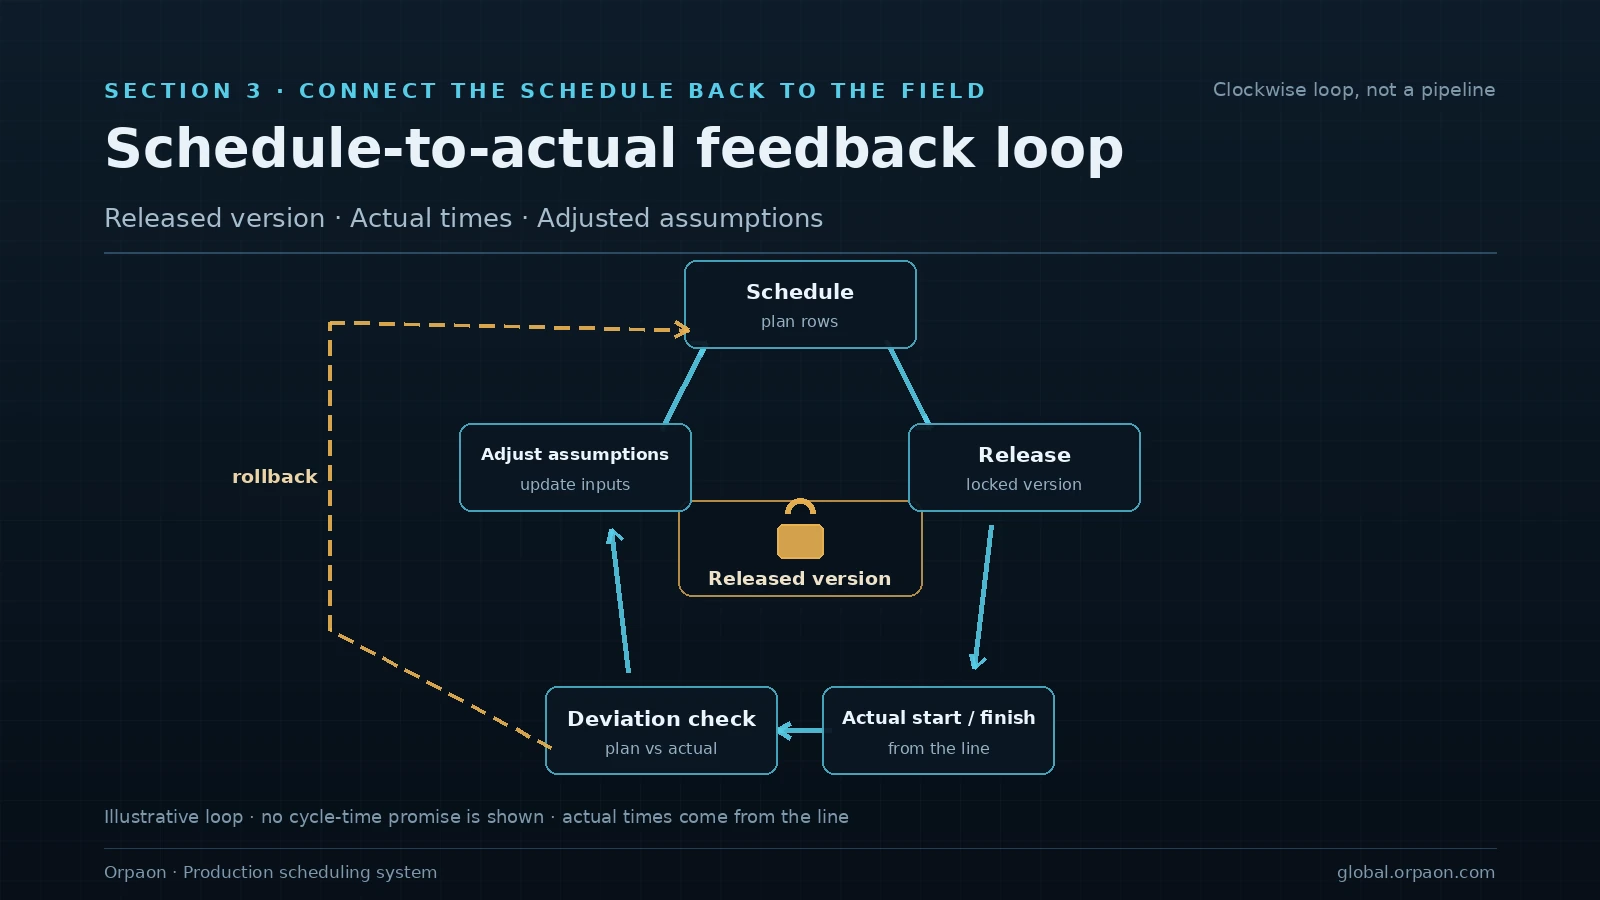
排程不是一次性的计算。计划下达之后的实际开工、完工与停机数据必须回写,否则下一轮排程仍在旧假设上继续推算,偏差会一轮一轮放大。这也是排程通常与设备联网、OEE 放在同一条数据链路上的原因:状态采集决定计划能否被验证。
- 计划下达即锁定版本:每改一次留一条变更记录,事后可以对照偏差来源
- 实际开工与完工时间回写:偏差超过约定阈值时,下一轮排程自动调整工时假设
- 瓶颈设备单独监控:瓶颈工序的停机与换型数据优先采集,排程结果对它最敏感
四、分三步推进:可执行、可对照、可优化
排程项目的时间多浪费在第一版就想做优化上。更稳妥的顺序是先把计划做到可执行,再让计划与现场对照,最后才谈优化目标;前两步没有走稳,第三步的比较就没有基准。
- 第一步:用有限产能排程替代手工排产,目标是计划可执行,不追求理想解
- 第二步:计划与实际逐周对照,修正工时、换型时间与齐套提前期
- 第三步:引入优化目标,如换型次数与交期达成,在约束稳定后比较不同方案
每一步都设回滚条件:若计划执行率连续数周低于约定水平,先回到手工排产并行运行,把约束定义修好再继续,而不是增加更多算法。
小结
生产排程系统的价值不在算法复杂度,而在计划能不能被班组执行、偏差能不能被解释:这次为什么插单、这台设备为什么连续换型、这批订单为什么还是晚了。约束三类写清、现场数据回写、三步推进加回滚条件,三件事做实之后,优化才有意义。动态插单与多目标自动优化属于推进中的方向,可按联合验证方式开展,不作交付承诺。